
2026-07-24 21:06
科技
中国算力觉醒:一场从替代到重构的硅基革命
中国算力觉醒:一场从替代到重构的硅基革命
从14nm到千卡超节点,国产AI芯片正以“够用、便宜、可控”的逻辑重写全球算力版图。
■
上海,2026年7月——盛夏的黄浦江畔,2026世界人工智能大会的展馆内人潮涌动。华为展台前,昇腾950超节点真机首次面向公众完整展示,围观者挤得水泄不通。这台基于灵衢互联协议、实现1024卡高速互联的庞然大物,斩获了大会最高荣誉SAIL奖。
就在四天前,另一场发布会在同一座城市低调举行。7月13日,东方算芯创始人魏少军——这位曾担任核高基国家科技重大专项技术总师的清华大学教授——在上海东郊宾馆向外界展示了DF1000芯片。这颗基于国内14nm制程的芯片,通过晶圆级混合键合3D堆叠工艺,实现了BF16精度下520 TFLOPS的算力。
两场发布会,两种技术路线,指向同一个事实:中国AI芯片产业正在经历一场深刻的重构。
市场拐点:从“用不上”到“不够用”
三年前,英伟达在中国AI加速卡市场的份额高达95%。彼时,国产芯片即便造出来,也无人敢用——“用不起来、不好用”是市场共识。
如今,这一格局已被彻底颠覆。据IDC与Bernstein联合数据,2026年第一季度中国AI加速卡市场中,国产芯片合计市占率首次突破52%,英伟达在华份额从三年前的95%骤降至8%。国产芯片正从“NVIDIA替代品”的叙事中走出,进入以“够用+便宜+可控”为新坐标的独立价值定价阶段。
推动这一转变的,首先是需求的井喷。字节跳动2026年AI基础设施支出计划已从去年底的1600亿元上调至逾2000亿元;阿里承诺未来三年投入3800亿元建设云和AI基础设施。与此同时,推理算力需求已超越训练成为主轴——日均Token调用量从2024年初约1000亿飙升至2026年3月超140万亿。
外部环境的倒逼同样关键。美国对华芯片出口管制层层加码,去年12月虽批准H200芯片有条件对华出口并征收25%税费,但实际发货量“极少”。一位业内人士的比喻直白而残酷:“以前觉得英伟达的芯片又好又便宜,没必要自己造,现在人家不卖了,我们只能自己干。”
生态破局:CUDA的“护城河”正在被填平
如果说硬件性能是国产芯片的第一道坎,那么软件生态才是真正的天堑。中国工程院院士郑纬民曾直言:“国产算力的瓶颈不在芯片,在生态。”
英伟达CUDA生态——数百万开发者、海量代码库和优化工具——曾被视作不可逾越的壁垒。但DeepSeek创始人梁文锋在7月23日流出的投资者交流会内部谈话中给出了截然不同的判断:“英伟达CUDA的护城河在快速地被瓦解。”
据梁文锋阐述,CUDA生态瓦解的核心原因有三:其一,AI已具备生成代码的能力,可以用AI来构建生态;其二,北京大学团队开发的开源高性能AI算子编程语言TileLang等新一代工具,能快速重写CUDA生态的算子;其三,运算芯片市场已超越游戏芯片市场,两者不再有绑定的理由。
华为昇腾的布局也在印证这一判断。2025年8月,华为正式宣布CANN异构计算架构开源开放。截至目前,CANN已开放50多个代码仓、800多个算子,完成Triton、TileLang引擎100%接口兼容。
更关键的信号来自DeepSeek本身。这家以“用更少算力做更强模型”著称的AI公司,其底层基础模型曾在英伟达H800上完成训练,但在美国出口管制后逐渐转向华为昇腾芯片。今年4月发布的DeepSeek-V4模型已全面适配昇腾架构。梁文锋透露,DeepSeek已与华为合作,拿到一万六千张950卡用于跑通生态,华为950超节点在性能和价格上可完全平替英伟达GB200、GB300。
系统级战争:从单卡到超节点
然而,硬件和生态的突破只是故事的开始。
当前高端AI芯片竞争面临三道门槛:先进制程、高带宽内存和CUDA生态。在先进制程受限的背景下,中国企业正在寻找另一条路径——系统级创新。
华为昇腾950超节点正是这一思路的集大成者。它实现了业界最大256TB跨物理节点的内存统一编址空间,RTT时延控制在3微秒以内。其意义不只是“卡更多了”,更在于“把这些卡组织得更高效”——减少通信损耗、提升并行效率。该集群可提供1 EFLOPS FP8与2 EFLOPS FP4的峰值算力。
这种从“单卡比拼”到“系统级较量”的转变,正在成为行业共识。国产算力芯片正由单卡性能竞争迈向超节点系统级竞争,持续向万卡、十万卡乃至百万卡集群互联演进。华为第一代昇腾384超节点已累计商用落地750余套,覆盖互联网、运营商、金融、教育及制造等行业。本届WAIC上,全国产十万卡AI超集群——曙光8000(登峰)真机也首次公开亮相,入选大会“镇馆之宝”。
东方算芯则选择了另一条技术路线。DF1000采用晶圆级混合键合3D堆叠工艺,通过存算垂直堆叠集成方案缩短数据传输路径,在14nm制程上实现了大算力输出。魏少军称,这条路线的核心逻辑是“探索出一条不依赖先进制程的高端算力发展路径”。
产能之困:最后的硬约束
尽管捷报频传,一个根本性问题仍未解决:产能。
梁文锋在投资者交流会上直言:“国产AI芯片的硬件和生态都没有问题,唯一有问题的是产能不够。”
他算了一笔账:若要训练与美国同等规模的大模型,需要5万张英伟达GB300芯片,或20万张华为950芯片。DeepSeek目前拥有约2万张H系列等效算力芯片,且多数是近两个月才到货。
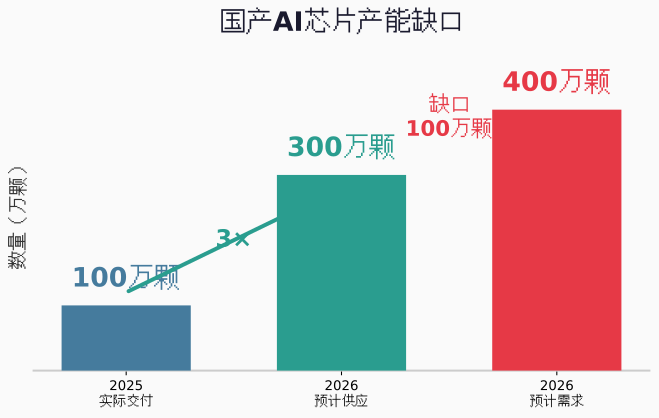
供需缺口触目惊心。据行业调研数据,2025年国产AI芯片实际交付约100万颗,2026年需求预计达400万颗,但供应能力仅约300万颗。高端AI加速卡、高带宽内存、先进封装等环节的供应链风险尤为突出。
梁文锋给出的时间表是一年——“预计一年内可扭转市场对国产芯片'用不起来、不好用'的认知”。但产能扩张需要时间,而窗口期不会无限敞开。
重构进行时
中美AI技术的代差目前约在6至18个月之间。梁文锋表示,DeepSeek的战略目标是把时间差缩到6个月、3个月,甚至在某些重点领域实现超越。
这不再是一场简单的追赶游戏。当国产芯片从“政策采购标的”转向“市场化主动选择”,当“够用+便宜+可控”成为新的价值坐标,全球AI算力格局正从单一主导走向多轨并行。
正如一位行业观察者所言:“这场竞争已经从中国本土延伸到了全球。”硅基革命的下一章,正在上海、深圳、北京的实验室和产线上被书写。
■
撰文 / OR
相关内容
相关内容

读者评论
科技
2026-07-24 21:06
中国算力觉醒:一场从替代到重构的硅基革命
中国算力觉醒:一场从替代到重构的硅基革命
从14nm到千卡超节点,国产AI芯片正以“够用、便宜、可控”的逻辑重写全球算力版图。
■
上海,2026年7月——盛夏的黄浦江畔,2026世界人工智能大会的展馆内人潮涌动。华为展台前,昇腾950超节点真机首次面向公众完整展示,围观者挤得水泄不通。这台基于灵衢互联协议、实现1024卡高速互联的庞然大物,斩获了大会最高荣誉SAIL奖。
就在四天前,另一场发布会在同一座城市低调举行。7月13日,东方算芯创始人魏少军——这位曾担任核高基国家科技重大专项技术总师的清华大学教授——在上海东郊宾馆向外界展示了DF1000芯片。这颗基于国内14nm制程的芯片,通过晶圆级混合键合3D堆叠工艺,实现了BF16精度下520 TFLOPS的算力。
两场发布会,两种技术路线,指向同一个事实:中国AI芯片产业正在经历一场深刻的重构。
市场拐点:从“用不上”到“不够用”
三年前,英伟达在中国AI加速卡市场的份额高达95%。彼时,国产芯片即便造出来,也无人敢用——“用不起来、不好用”是市场共识。
如今,这一格局已被彻底颠覆。据IDC与Bernstein联合数据,2026年第一季度中国AI加速卡市场中,国产芯片合计市占率首次突破52%,英伟达在华份额从三年前的95%骤降至8%。国产芯片正从“NVIDIA替代品”的叙事中走出,进入以“够用+便宜+可控”为新坐标的独立价值定价阶段。
推动这一转变的,首先是需求的井喷。字节跳动2026年AI基础设施支出计划已从去年底的1600亿元上调至逾2000亿元;阿里承诺未来三年投入3800亿元建设云和AI基础设施。与此同时,推理算力需求已超越训练成为主轴——日均Token调用量从2024年初约1000亿飙升至2026年3月超140万亿。
外部环境的倒逼同样关键。美国对华芯片出口管制层层加码,去年12月虽批准H200芯片有条件对华出口并征收25%税费,但实际发货量“极少”。一位业内人士的比喻直白而残酷:“以前觉得英伟达的芯片又好又便宜,没必要自己造,现在人家不卖了,我们只能自己干。”
生态破局:CUDA的“护城河”正在被填平
如果说硬件性能是国产芯片的第一道坎,那么软件生态才是真正的天堑。中国工程院院士郑纬民曾直言:“国产算力的瓶颈不在芯片,在生态。”
英伟达CUDA生态——数百万开发者、海量代码库和优化工具——曾被视作不可逾越的壁垒。但DeepSeek创始人梁文锋在7月23日流出的投资者交流会内部谈话中给出了截然不同的判断:“英伟达CUDA的护城河在快速地被瓦解。”
据梁文锋阐述,CUDA生态瓦解的核心原因有三:其一,AI已具备生成代码的能力,可以用AI来构建生态;其二,北京大学团队开发的开源高性能AI算子编程语言TileLang等新一代工具,能快速重写CUDA生态的算子;其三,运算芯片市场已超越游戏芯片市场,两者不再有绑定的理由。
华为昇腾的布局也在印证这一判断。2025年8月,华为正式宣布CANN异构计算架构开源开放。截至目前,CANN已开放50多个代码仓、800多个算子,完成Triton、TileLang引擎100%接口兼容。
更关键的信号来自DeepSeek本身。这家以“用更少算力做更强模型”著称的AI公司,其底层基础模型曾在英伟达H800上完成训练,但在美国出口管制后逐渐转向华为昇腾芯片。今年4月发布的DeepSeek-V4模型已全面适配昇腾架构。梁文锋透露,DeepSeek已与华为合作,拿到一万六千张950卡用于跑通生态,华为950超节点在性能和价格上可完全平替英伟达GB200、GB300。
系统级战争:从单卡到超节点
然而,硬件和生态的突破只是故事的开始。
当前高端AI芯片竞争面临三道门槛:先进制程、高带宽内存和CUDA生态。在先进制程受限的背景下,中国企业正在寻找另一条路径——系统级创新。
华为昇腾950超节点正是这一思路的集大成者。它实现了业界最大256TB跨物理节点的内存统一编址空间,RTT时延控制在3微秒以内。其意义不只是“卡更多了”,更在于“把这些卡组织得更高效”——减少通信损耗、提升并行效率。该集群可提供1 EFLOPS FP8与2 EFLOPS FP4的峰值算力。
这种从“单卡比拼”到“系统级较量”的转变,正在成为行业共识。国产算力芯片正由单卡性能竞争迈向超节点系统级竞争,持续向万卡、十万卡乃至百万卡集群互联演进。华为第一代昇腾384超节点已累计商用落地750余套,覆盖互联网、运营商、金融、教育及制造等行业。本届WAIC上,全国产十万卡AI超集群——曙光8000(登峰)真机也首次公开亮相,入选大会“镇馆之宝”。
东方算芯则选择了另一条技术路线。DF1000采用晶圆级混合键合3D堆叠工艺,通过存算垂直堆叠集成方案缩短数据传输路径,在14nm制程上实现了大算力输出。魏少军称,这条路线的核心逻辑是“探索出一条不依赖先进制程的高端算力发展路径”。
产能之困:最后的硬约束
尽管捷报频传,一个根本性问题仍未解决:产能。
梁文锋在投资者交流会上直言:“国产AI芯片的硬件和生态都没有问题,唯一有问题的是产能不够。”
他算了一笔账:若要训练与美国同等规模的大模型,需要5万张英伟达GB300芯片,或20万张华为950芯片。DeepSeek目前拥有约2万张H系列等效算力芯片,且多数是近两个月才到货。
供需缺口触目惊心。据行业调研数据,2025年国产AI芯片实际交付约100万颗,2026年需求预计达400万颗,但供应能力仅约300万颗。高端AI加速卡、高带宽内存、先进封装等环节的供应链风险尤为突出。
梁文锋给出的时间表是一年——“预计一年内可扭转市场对国产芯片'用不起来、不好用'的认知”。但产能扩张需要时间,而窗口期不会无限敞开。
重构进行时
中美AI技术的代差目前约在6至18个月之间。梁文锋表示,DeepSeek的战略目标是把时间差缩到6个月、3个月,甚至在某些重点领域实现超越。
这不再是一场简单的追赶游戏。当国产芯片从“政策采购标的”转向“市场化主动选择”,当“够用+便宜+可控”成为新的价值坐标,全球AI算力格局正从单一主导走向多轨并行。
正如一位行业观察者所言:“这场竞争已经从中国本土延伸到了全球。”硅基革命的下一章,正在上海、深圳、北京的实验室和产线上被书写。
■
撰文 / OR
相关内容
相关内容
读者评论OR
读者评论
OR
2条评论,1人参与。

在移动设备生成「OR」
app:
OR 启用新域名> |
特别推荐

最受欢迎


分享:




■ 或者, 留一段影像,回一曲挂牵。丝丝入扣、暖暖心灵 ,需飘过的醇厚与共。
■ 或者,热烈空雨伴芬芳泥土;绿绿生命缠锐意骄阳。
回望,回望,一马平川红酒飘散断归途。
■ 或者,灰蒙蒙空气重回道指一万四千点。滚动时光,照进现实,流逝过往,回归未来。
■ 或者,热烈空雨伴芬芳泥土;绿绿生命缠锐意骄阳。
回望,回望,一马平川红酒飘散断归途。
■ 或者,灰蒙蒙空气重回道指一万四千点。滚动时光,照进现实,流逝过往,回归未来。
2条评论,1人参与。