
2026-07-24 07:32
科技
克制者的赌局:DeepSeek 710亿美元估值与一场反商业实验
克制者的赌局:DeepSeek 710亿美元估值与一场反商业实验
创始人梁文锋详解为何不做"下一个字节跳动",以及AI竞赛中那条少有人走的路。
■
杭州城西的某个会议室里,空调开得很足。四个小时,一百一十八个问题。在场的人后来回忆,梁文锋的语速始终平稳,像在讲解一道复杂的数学题,而不是在描述一家估值七百一十亿美元公司的未来。
这是2026年7月的一场投资者交流会。在场的人带着各自的算盘:有人想知道DeepSeek什么时候推出C端超级应用,有人关心它何时能复制字节跳动的流量神话,还有人直接问,这家公司到底想不想赚钱。梁文锋的回答让部分听众感到困惑——他说,DeepSeek不追求成为"下一个字节"或"下一个腾讯"。
在当下的中国科技语境里,这句话近乎叛逆。
一、反商业的姿态
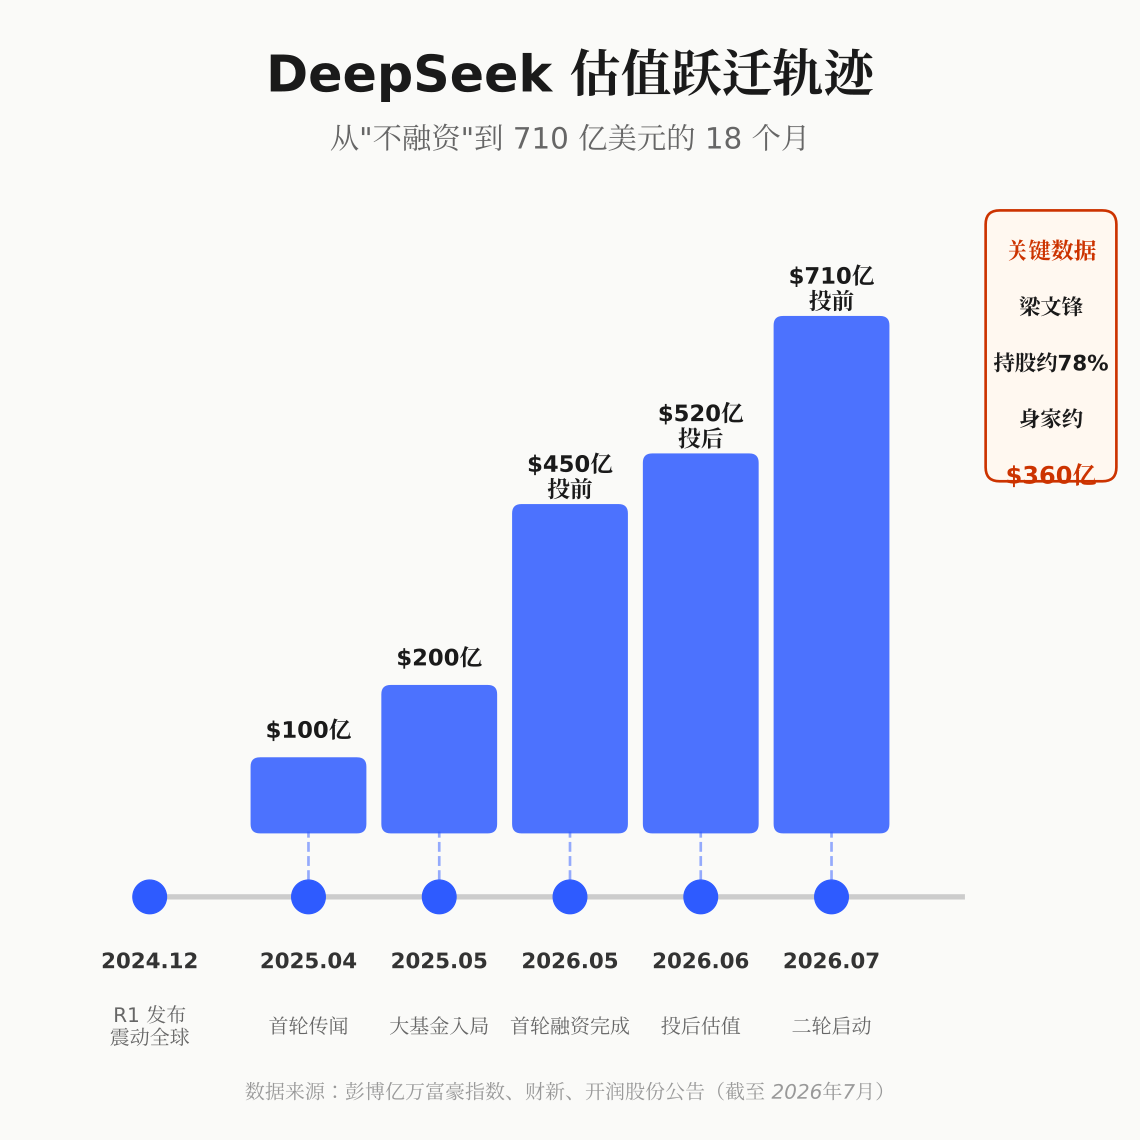
要理解这句话的分量,得先看看DeepSeek此刻所处的位置。这家公司刚刚完成了中国有史以来最大规模的AI单轮融资——超过五百亿元人民币(约七十四亿美元),投后估值突破五百二十亿美元。仅仅六周后,第二轮融资启动,投前估值跳升至七百一十亿美元。创始人梁文锋持股约百分之七十八,身家约三百六十亿美元,超越Anthropic的Dario Amodei等人,成为持有AI模型公司股权的创始人中身家最高者。
然而,与这笔巨额财富形成鲜明对比的,是梁文锋对商业化的冷淡。DeepSeek的年化收入约为四至五亿美元,API毛利率超过百分之五十,使用成本仅为OpenAI的十几分之一。但这些数字似乎并没有让他兴奋。他说,当前争夺C端流量或To B收入并不是公司最关注的问题。
这种姿态在资本狂热的2026年显得格格不入。当智谱AI和MiniMax先后登陆港股,当月之暗面的Kimi智能助手在长文本赛道一路狂奔,当字节跳动的豆包推出三档付费订阅、专业版高达每月五百元——整个行业都在急切地证明AI可以变成一门好生意。DeepSeek却选择了一条相反的路:它把内部使用的模型与开源版本保持一致,不向外发布性能较低的"阉割版";它拒绝在3D生成、视频生成和世界模型上投入重兵,因为"多模态只是AI系统中的一个组件,并非智能发展的核心路线"。
这不是清高,而是一种经过精密计算的战略克制。梁文锋的逻辑很简单:在通用人工智能(AGI)尚未到来之前,过早的商业化会扭曲技术演进的路径。如果一家公司过早地依赖某一类收入,它的研发方向就会不可避免地向付费客户的需求倾斜,而不是向真正的智能突破倾斜。历史上有太多这样的先例——曾经伟大的技术公司,因为太早找到了赚钱的方式,而错过了下一个时代的船票。
二、爬楼梯的人
如果商业化不是目标,那什么是?
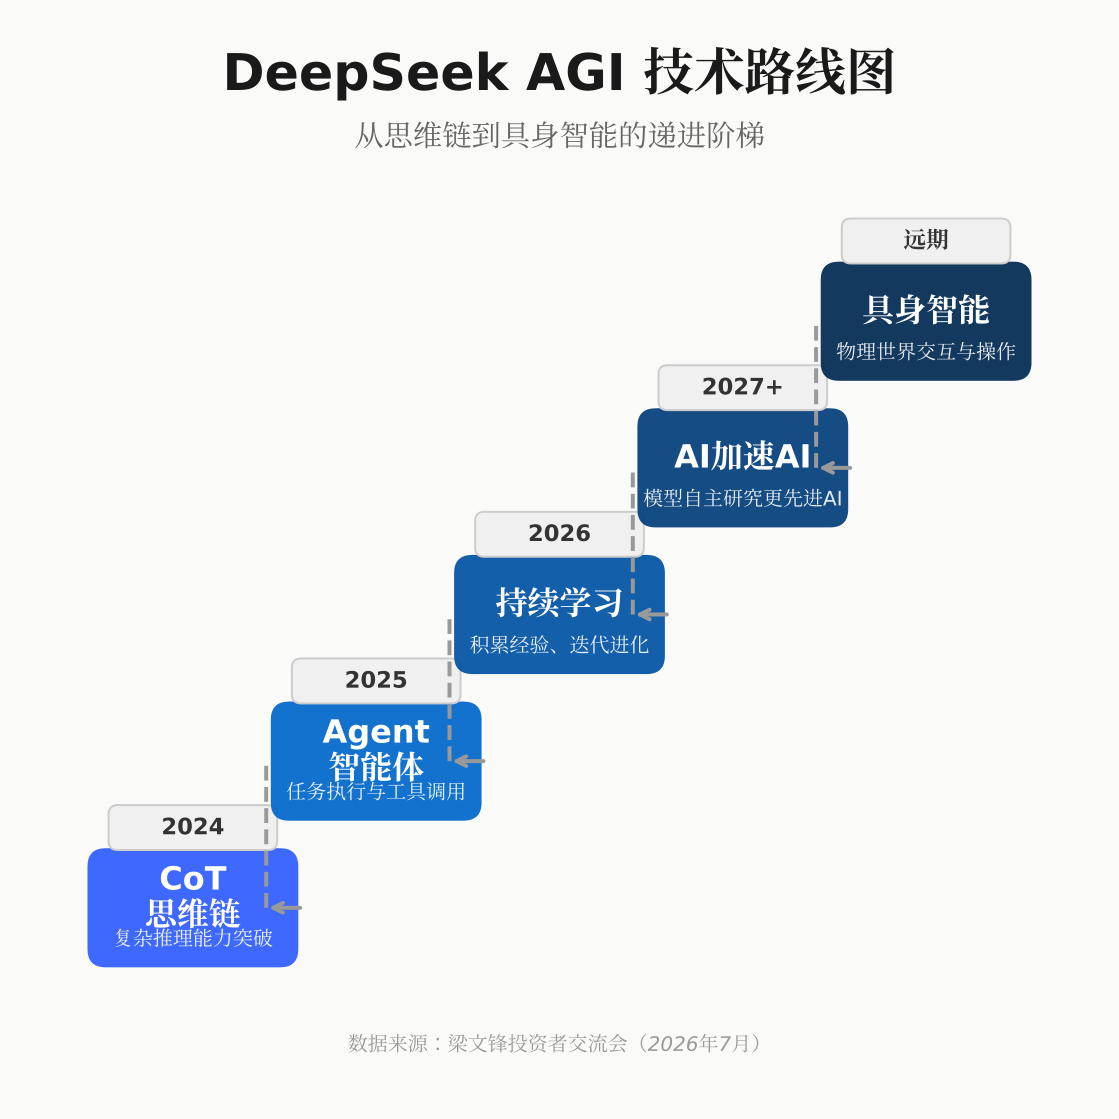
梁文锋给出了一个清晰的阶梯:去年解决的是CoT(思维链),今年的重点是Agent(智能体),Agent之后需要解决持续学习问题。当AI具备持续学习能力后,可能进入一个渐进式突破阶段——"模型能够完成更多人类工作,并帮助自身研发更先进的人工智能系统,实现AI加速AI研究"。这之后,才可能进一步发展到具身智能。
这个路线图的关键在于"持续学习"。梁文锋认为,当前AI最大的缺失并非能力,而是持续学习能力。"人类可以持续积累经验,但目前AI需要输入完整上下文才能完成任务,这限制了AI替代人类工作的能力。"
这是一个被行业长期忽视的痛点。今天的大模型,无论多么强大,本质上都是" Stateless"(无状态)的——每次对话都是一次全新的开始,模型不会记住你上周教给它的东西,也不会在无数次交互中自动优化自己的行为。解决这个问题,意味着AI将从"工具"变成"同事",从"应答器"变成"进化体"。
DeepSeek的技术路线选择,也解释了它为何对多模态保持克制。在梁文锋看来,视频生成和3D建模固然热闹,但它们更像是AI能力的"展示窗",而非通向AGI的"主楼梯"。真正的智能突破发生在推理层、发生在学习机制、发生在模型能否像人类一样在开放环境中自主进化。这种判断带有明显的"第一性原理"色彩——它假设智能的本质是信息处理与自我改进的能力,而不是感知通道的丰富程度。
三、开源的阳谋
DeepSeek最鲜明的标签是开源。在这个标签之下,外界往往只看到理想主义,却忽略了其中的冷峻计算。
梁文锋并不讳言开源意味着"让利"。但他同时指出,开源能够增强员工成就感、提升组织凝聚力,并有助于整个AI生态发展。更重要的是,DeepSeek开源模型与内部使用模型保持一致,"不会向外发布性能较低版本"。
这一表态打破了行业惯例。通常情况下,开源模型公司会保留一个更强大的内部版本作为商业壁垒。DeepSeek的反常举动,让竞争对手既困惑又警惕——它似乎在用一种近乎"自杀式"的开放,换取某种更长远的东西。
这种东西可能是标准制定权。在AI模型快速迭代的当下,下游开发者和企业用户面临巨大的切换成本。如果DeepSeek的开源模型成为行业默认基座,那么无论模型如何升级,生态都将围绕它的架构、接口和训练范式展开。这是一种"用生态换时间"的策略:在AGI到来前的窗口期,通过让利建立事实上的行业标准,锁定未来数年的技术演进路径。
梁文锋对此并不担心竞争。"并非所有企业都具备持续投入大模型研发的能力。"这句话的背后,是对AI研发成本曲线的深刻理解。大模型竞赛正在从"百模大战"进入"寡头时代",资源高度集中,中小玩家逐步出局。DeepSeek的开源,实际上是在加速这一分化——它让没有自研能力的公司也能用上顶级模型,从而降低了它们自建团队的动机,最终巩固了头部玩家的地位。
四、资本的悖论
然而,DeepSeek的"反商业"姿态,恰恰成了它最大的商业价值。
2024年12月,DeepSeek发布R1推理模型,以极低的训练成本震动全球AI界。当时没有人想到,这家一度宣称"不融资、不上市、不商业化"的公司,会在十八个月内完成估值从一百亿美元到七百一十亿美元的跃迁。更讽刺的是,梁文锋本人出资约二百亿元人民币参与首轮融资,成为最大单一出资方——创始人用真金白银押注自己的"不追求利润"哲学,而资本市场用更高的估值回报了他的信念。
这种悖论揭示了一个深层逻辑:在AI这个赛道,"信仰"本身已经成为一种稀缺资产。当OpenAI在闭源与开源之间摇摆,当Anthropic的安全主义被商业化压力稀释,当字节跳动和腾讯用流量思维改造AI产品——DeepSeek的"克制"反而成了一种差异化定位。投资者买的不是它现在的收入,而是它"不被短期利益扭曲"的可能性。
但这种定位能持续多久?DeepSeek已经启动了上市筹备,计划最早于2026年底提交申请、2027年挂牌。一旦进入公开市场,它将面临季度财报的压力、股东回报的要求、股价波动的拷问。届时,"克制"是否还能是一种选择,还是不得不让位于"增长"?
五、从软件到系统
DeepSeek的野心不止于模型层。2026年7月,路透社披露该公司正在自主研发AI推理芯片,项目已启动约一年。这款芯片面向推理场景而非训练,旨在降低对英伟达和华为的依赖。
这一举动标志着中国AI竞争正在从"模型层"下沉到"系统层"。全球头部AI公司——Google的TPU、Meta的MTIA、Amazon的Inferentia、微软的Maia、OpenAI与博通合作的芯片项目——都在做同一件事:把业务边界从算法延伸到硬件,从软件公司变成系统公司。
背后的驱动力是AI商业模式的根本转变。过去两年,行业重心从"训练竞赛"转向"推理战争"。训练是一次性的资本支出,推理是持续性的运营消耗。随着用户规模和Token调用量激增,推理成本正在成为模型公司最大的支出项。专用推理芯片如果围绕固定模型优化,理论上可以大幅降低单位调用成本——这对以低价策略著称的DeepSeek尤为关键。
更深层看,自研芯片也是供应链安全的必选项。在美国出口管制持续收紧的背景下,英伟达最先进GPU对华供应受限,华为昇腾虽已成为中国AI芯片市场的重要供应商,但单一依赖仍存在风险。DeepSeek的芯片战略,本质上是在构建一条"英伟达→华为→自研"的三级跳路径,逐步掌握算力自主权。
六、整合不可避免
对于行业格局,梁文锋的判断冷静而残酷:国内大模型企业数量太多,资源过于分散,"未来行业一定会经历整合"。他认为,如果企业只获取合理利润,市场可能并不需要大量公司同时投入基础模型研发。
这个判断与资本流向高度吻合。2026年第一季度,全球AI初创企业共筹集了两千五百五十五亿美元资金,超过2025年全年总额。其中三分之二由三笔超级交易贡献——OpenAI的一千二百二十亿美元、Anthropic的三百亿美元,以及DeepSeek的五百亿元。钱正在向极少数头部集中,"六小虎"的格局已经分化:智谱AI和MiniMax先后登陆港股,月之暗面估值突破二百亿美元,阶跃星辰冲刺上市,而DeepSeek以七百一十亿美元的估值一骑绝尘。
梁文锋对中美AI竞争的看法同样务实。他认为双方差距主要体现在资源方面,而不是人才。"中国AI人才储备并不缺乏,当前差距更多来自算力资源投入。"他希望"通过更高的计算效率,用更少的算力缩短差距"。模型竞争最终会体现在成本、时间和用户体验三个方面,"其中成本最为关键"。
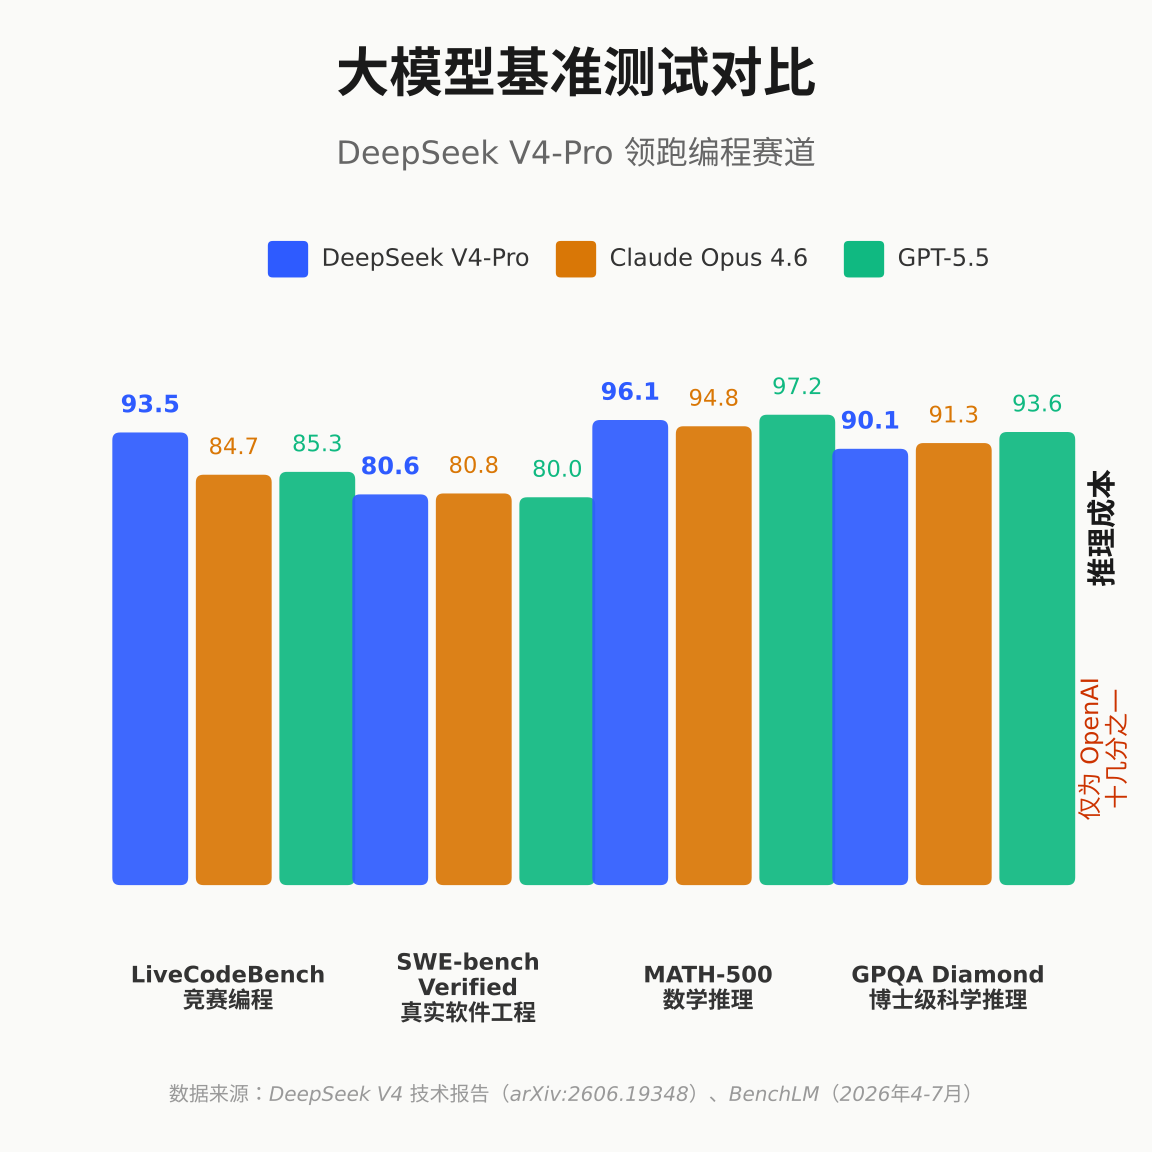
这是一个典型的工程师式回答——不诉诸民族主义情绪,而是把竞争还原为可量化的效率问题。DeepSeek的V4-Pro模型,总参数量达1.6万亿、每Token仅激活490亿参数,在LiveCodeBench竞赛编程基准上以93.5%的成绩大幅领先Claude Opus 4.6(84.7%)和GPT-5.5(85.3%),在SWE-bench Verified真实软件工程测试中与竞品并驾齐驱(80.6%),同时推理成本仅为竞品的十几分之一。这种"用架构创新换算力效率"的路径,正是梁文锋所说的"更高计算效率"的具象化。
七、尾声:时间的敌人
四个小时的投资人交流会结束后,有人问梁文锋:DeepSeek的终极对手是谁?
他没有提OpenAI,也没有提字节跳动。他说,最大的挑战是时间——AGI到来之前,如何保持组织的纯粹性;上市之后,如何抵御短期主义的侵蚀;开源生态扩大之后,如何防止技术路线被下游需求绑架。
这些问题没有标准答案。在AI这个以周为单位的行业里,DeepSeek选择了一种以年为单位的耐心。它用五百亿元融资买来的是十二个月的时间窗口,用七百一十亿美元估值兑换的是不被股东逼问季度收入的缓冲地带。
这是一场关于耐心的赌局。赌注是:在所有人都在加速的时候,慢下来的人反而能走得更远。
但历史对"克制者"并不总是仁慈。诺基亚曾经克制,柯达曾经克制,太多公司在"不追求短期利润"的美名中错过了技术革命的转折点。DeepSeek的不同之处在于,它的克制不是保守,而是聚焦——把所有资源押注在一条最陡峭但最清晰的技术路线上,赌AGI会在某个时刻突然降临,而届时只有做好准备的人才能接住它。
杭州城西的会议室灯光已经熄灭。但算法还在运行,模型还在训练,那台价值数十亿美元的超级计算机仍在深夜发出低沉的嗡鸣。在这个声音里,有人听到了理想主义,有人听到了资本叙事,还有人听到了一个古老命题的新版本:在贪婪与信仰之间,科技公司究竟有没有第三条路?
梁文锋和他的DeepSeek,正在用七百一十亿美元的估值,为这个问题写下一个昂贵的注脚。
■
撰文 / OR
题图来源:YouTube
相关内容
相关内容

读者评论
科技
2026-07-24 07:32
克制者的赌局:DeepSeek 710亿美元估值与一场反商业实验
克制者的赌局:DeepSeek 710亿美元估值与一场反商业实验
创始人梁文锋详解为何不做"下一个字节跳动",以及AI竞赛中那条少有人走的路。
■
杭州城西的某个会议室里,空调开得很足。四个小时,一百一十八个问题。在场的人后来回忆,梁文锋的语速始终平稳,像在讲解一道复杂的数学题,而不是在描述一家估值七百一十亿美元公司的未来。
这是2026年7月的一场投资者交流会。在场的人带着各自的算盘:有人想知道DeepSeek什么时候推出C端超级应用,有人关心它何时能复制字节跳动的流量神话,还有人直接问,这家公司到底想不想赚钱。梁文锋的回答让部分听众感到困惑——他说,DeepSeek不追求成为"下一个字节"或"下一个腾讯"。
在当下的中国科技语境里,这句话近乎叛逆。
一、反商业的姿态
要理解这句话的分量,得先看看DeepSeek此刻所处的位置。这家公司刚刚完成了中国有史以来最大规模的AI单轮融资——超过五百亿元人民币(约七十四亿美元),投后估值突破五百二十亿美元。仅仅六周后,第二轮融资启动,投前估值跳升至七百一十亿美元。创始人梁文锋持股约百分之七十八,身家约三百六十亿美元,超越Anthropic的Dario Amodei等人,成为持有AI模型公司股权的创始人中身家最高者。
然而,与这笔巨额财富形成鲜明对比的,是梁文锋对商业化的冷淡。DeepSeek的年化收入约为四至五亿美元,API毛利率超过百分之五十,使用成本仅为OpenAI的十几分之一。但这些数字似乎并没有让他兴奋。他说,当前争夺C端流量或To B收入并不是公司最关注的问题。
这种姿态在资本狂热的2026年显得格格不入。当智谱AI和MiniMax先后登陆港股,当月之暗面的Kimi智能助手在长文本赛道一路狂奔,当字节跳动的豆包推出三档付费订阅、专业版高达每月五百元——整个行业都在急切地证明AI可以变成一门好生意。DeepSeek却选择了一条相反的路:它把内部使用的模型与开源版本保持一致,不向外发布性能较低的"阉割版";它拒绝在3D生成、视频生成和世界模型上投入重兵,因为"多模态只是AI系统中的一个组件,并非智能发展的核心路线"。
这不是清高,而是一种经过精密计算的战略克制。梁文锋的逻辑很简单:在通用人工智能(AGI)尚未到来之前,过早的商业化会扭曲技术演进的路径。如果一家公司过早地依赖某一类收入,它的研发方向就会不可避免地向付费客户的需求倾斜,而不是向真正的智能突破倾斜。历史上有太多这样的先例——曾经伟大的技术公司,因为太早找到了赚钱的方式,而错过了下一个时代的船票。
二、爬楼梯的人
如果商业化不是目标,那什么是?
梁文锋给出了一个清晰的阶梯:去年解决的是CoT(思维链),今年的重点是Agent(智能体),Agent之后需要解决持续学习问题。当AI具备持续学习能力后,可能进入一个渐进式突破阶段——"模型能够完成更多人类工作,并帮助自身研发更先进的人工智能系统,实现AI加速AI研究"。这之后,才可能进一步发展到具身智能。
这个路线图的关键在于"持续学习"。梁文锋认为,当前AI最大的缺失并非能力,而是持续学习能力。"人类可以持续积累经验,但目前AI需要输入完整上下文才能完成任务,这限制了AI替代人类工作的能力。"
这是一个被行业长期忽视的痛点。今天的大模型,无论多么强大,本质上都是" Stateless"(无状态)的——每次对话都是一次全新的开始,模型不会记住你上周教给它的东西,也不会在无数次交互中自动优化自己的行为。解决这个问题,意味着AI将从"工具"变成"同事",从"应答器"变成"进化体"。
DeepSeek的技术路线选择,也解释了它为何对多模态保持克制。在梁文锋看来,视频生成和3D建模固然热闹,但它们更像是AI能力的"展示窗",而非通向AGI的"主楼梯"。真正的智能突破发生在推理层、发生在学习机制、发生在模型能否像人类一样在开放环境中自主进化。这种判断带有明显的"第一性原理"色彩——它假设智能的本质是信息处理与自我改进的能力,而不是感知通道的丰富程度。
三、开源的阳谋
DeepSeek最鲜明的标签是开源。在这个标签之下,外界往往只看到理想主义,却忽略了其中的冷峻计算。
梁文锋并不讳言开源意味着"让利"。但他同时指出,开源能够增强员工成就感、提升组织凝聚力,并有助于整个AI生态发展。更重要的是,DeepSeek开源模型与内部使用模型保持一致,"不会向外发布性能较低版本"。
这一表态打破了行业惯例。通常情况下,开源模型公司会保留一个更强大的内部版本作为商业壁垒。DeepSeek的反常举动,让竞争对手既困惑又警惕——它似乎在用一种近乎"自杀式"的开放,换取某种更长远的东西。
这种东西可能是标准制定权。在AI模型快速迭代的当下,下游开发者和企业用户面临巨大的切换成本。如果DeepSeek的开源模型成为行业默认基座,那么无论模型如何升级,生态都将围绕它的架构、接口和训练范式展开。这是一种"用生态换时间"的策略:在AGI到来前的窗口期,通过让利建立事实上的行业标准,锁定未来数年的技术演进路径。
梁文锋对此并不担心竞争。"并非所有企业都具备持续投入大模型研发的能力。"这句话的背后,是对AI研发成本曲线的深刻理解。大模型竞赛正在从"百模大战"进入"寡头时代",资源高度集中,中小玩家逐步出局。DeepSeek的开源,实际上是在加速这一分化——它让没有自研能力的公司也能用上顶级模型,从而降低了它们自建团队的动机,最终巩固了头部玩家的地位。
四、资本的悖论
然而,DeepSeek的"反商业"姿态,恰恰成了它最大的商业价值。
2024年12月,DeepSeek发布R1推理模型,以极低的训练成本震动全球AI界。当时没有人想到,这家一度宣称"不融资、不上市、不商业化"的公司,会在十八个月内完成估值从一百亿美元到七百一十亿美元的跃迁。更讽刺的是,梁文锋本人出资约二百亿元人民币参与首轮融资,成为最大单一出资方——创始人用真金白银押注自己的"不追求利润"哲学,而资本市场用更高的估值回报了他的信念。
这种悖论揭示了一个深层逻辑:在AI这个赛道,"信仰"本身已经成为一种稀缺资产。当OpenAI在闭源与开源之间摇摆,当Anthropic的安全主义被商业化压力稀释,当字节跳动和腾讯用流量思维改造AI产品——DeepSeek的"克制"反而成了一种差异化定位。投资者买的不是它现在的收入,而是它"不被短期利益扭曲"的可能性。
但这种定位能持续多久?DeepSeek已经启动了上市筹备,计划最早于2026年底提交申请、2027年挂牌。一旦进入公开市场,它将面临季度财报的压力、股东回报的要求、股价波动的拷问。届时,"克制"是否还能是一种选择,还是不得不让位于"增长"?
五、从软件到系统
DeepSeek的野心不止于模型层。2026年7月,路透社披露该公司正在自主研发AI推理芯片,项目已启动约一年。这款芯片面向推理场景而非训练,旨在降低对英伟达和华为的依赖。
这一举动标志着中国AI竞争正在从"模型层"下沉到"系统层"。全球头部AI公司——Google的TPU、Meta的MTIA、Amazon的Inferentia、微软的Maia、OpenAI与博通合作的芯片项目——都在做同一件事:把业务边界从算法延伸到硬件,从软件公司变成系统公司。
背后的驱动力是AI商业模式的根本转变。过去两年,行业重心从"训练竞赛"转向"推理战争"。训练是一次性的资本支出,推理是持续性的运营消耗。随着用户规模和Token调用量激增,推理成本正在成为模型公司最大的支出项。专用推理芯片如果围绕固定模型优化,理论上可以大幅降低单位调用成本——这对以低价策略著称的DeepSeek尤为关键。
更深层看,自研芯片也是供应链安全的必选项。在美国出口管制持续收紧的背景下,英伟达最先进GPU对华供应受限,华为昇腾虽已成为中国AI芯片市场的重要供应商,但单一依赖仍存在风险。DeepSeek的芯片战略,本质上是在构建一条"英伟达→华为→自研"的三级跳路径,逐步掌握算力自主权。
六、整合不可避免
对于行业格局,梁文锋的判断冷静而残酷:国内大模型企业数量太多,资源过于分散,"未来行业一定会经历整合"。他认为,如果企业只获取合理利润,市场可能并不需要大量公司同时投入基础模型研发。
这个判断与资本流向高度吻合。2026年第一季度,全球AI初创企业共筹集了两千五百五十五亿美元资金,超过2025年全年总额。其中三分之二由三笔超级交易贡献——OpenAI的一千二百二十亿美元、Anthropic的三百亿美元,以及DeepSeek的五百亿元。钱正在向极少数头部集中,"六小虎"的格局已经分化:智谱AI和MiniMax先后登陆港股,月之暗面估值突破二百亿美元,阶跃星辰冲刺上市,而DeepSeek以七百一十亿美元的估值一骑绝尘。
梁文锋对中美AI竞争的看法同样务实。他认为双方差距主要体现在资源方面,而不是人才。"中国AI人才储备并不缺乏,当前差距更多来自算力资源投入。"他希望"通过更高的计算效率,用更少的算力缩短差距"。模型竞争最终会体现在成本、时间和用户体验三个方面,"其中成本最为关键"。
这是一个典型的工程师式回答——不诉诸民族主义情绪,而是把竞争还原为可量化的效率问题。DeepSeek的V4-Pro模型,总参数量达1.6万亿、每Token仅激活490亿参数,在LiveCodeBench竞赛编程基准上以93.5%的成绩大幅领先Claude Opus 4.6(84.7%)和GPT-5.5(85.3%),在SWE-bench Verified真实软件工程测试中与竞品并驾齐驱(80.6%),同时推理成本仅为竞品的十几分之一。这种"用架构创新换算力效率"的路径,正是梁文锋所说的"更高计算效率"的具象化。
七、尾声:时间的敌人
四个小时的投资人交流会结束后,有人问梁文锋:DeepSeek的终极对手是谁?
他没有提OpenAI,也没有提字节跳动。他说,最大的挑战是时间——AGI到来之前,如何保持组织的纯粹性;上市之后,如何抵御短期主义的侵蚀;开源生态扩大之后,如何防止技术路线被下游需求绑架。
这些问题没有标准答案。在AI这个以周为单位的行业里,DeepSeek选择了一种以年为单位的耐心。它用五百亿元融资买来的是十二个月的时间窗口,用七百一十亿美元估值兑换的是不被股东逼问季度收入的缓冲地带。
这是一场关于耐心的赌局。赌注是:在所有人都在加速的时候,慢下来的人反而能走得更远。
但历史对"克制者"并不总是仁慈。诺基亚曾经克制,柯达曾经克制,太多公司在"不追求短期利润"的美名中错过了技术革命的转折点。DeepSeek的不同之处在于,它的克制不是保守,而是聚焦——把所有资源押注在一条最陡峭但最清晰的技术路线上,赌AGI会在某个时刻突然降临,而届时只有做好准备的人才能接住它。
杭州城西的会议室灯光已经熄灭。但算法还在运行,模型还在训练,那台价值数十亿美元的超级计算机仍在深夜发出低沉的嗡鸣。在这个声音里,有人听到了理想主义,有人听到了资本叙事,还有人听到了一个古老命题的新版本:在贪婪与信仰之间,科技公司究竟有没有第三条路?
梁文锋和他的DeepSeek,正在用七百一十亿美元的估值,为这个问题写下一个昂贵的注脚。
■
撰文 / OR
题图来源:YouTube
相关内容
相关内容
读者评论OR
读者评论
OR
2条评论,1人参与。

在移动设备生成「OR」
app:
OR 启用新域名> |
特别推荐

最受欢迎


分享:




■ 或者, 留一段影像,回一曲挂牵。丝丝入扣、暖暖心灵 ,需飘过的醇厚与共。
■ 或者,热烈空雨伴芬芳泥土;绿绿生命缠锐意骄阳。
回望,回望,一马平川红酒飘散断归途。
■ 或者,灰蒙蒙空气重回道指一万四千点。滚动时光,照进现实,流逝过往,回归未来。
■ 或者,热烈空雨伴芬芳泥土;绿绿生命缠锐意骄阳。
回望,回望,一马平川红酒飘散断归途。
■ 或者,灰蒙蒙空气重回道指一万四千点。滚动时光,照进现实,流逝过往,回归未来。
2条评论,1人参与。